阅读文献目录在右侧,可点击快速跳转。
1、REACT ICLR 2023
标题:REACT: SYNERGIZING REASONING AND ACTING IN LANGUAGE MODELS REACT:语言模型中推理与行动的协同作用
这一篇是本方向的开篇之作,相较于CoT(Chain of Thought,思维链)和Act-Only,本文创新采用ReAct(Reason+Act)的Thought-Act-Observation的三段式方式解决问题,方便LLM决策工具。下图为示例问题和各种方法的思考过程,可以看到ReAct能够正确思考并实现操作,为后续的Tool Planning打下基础。
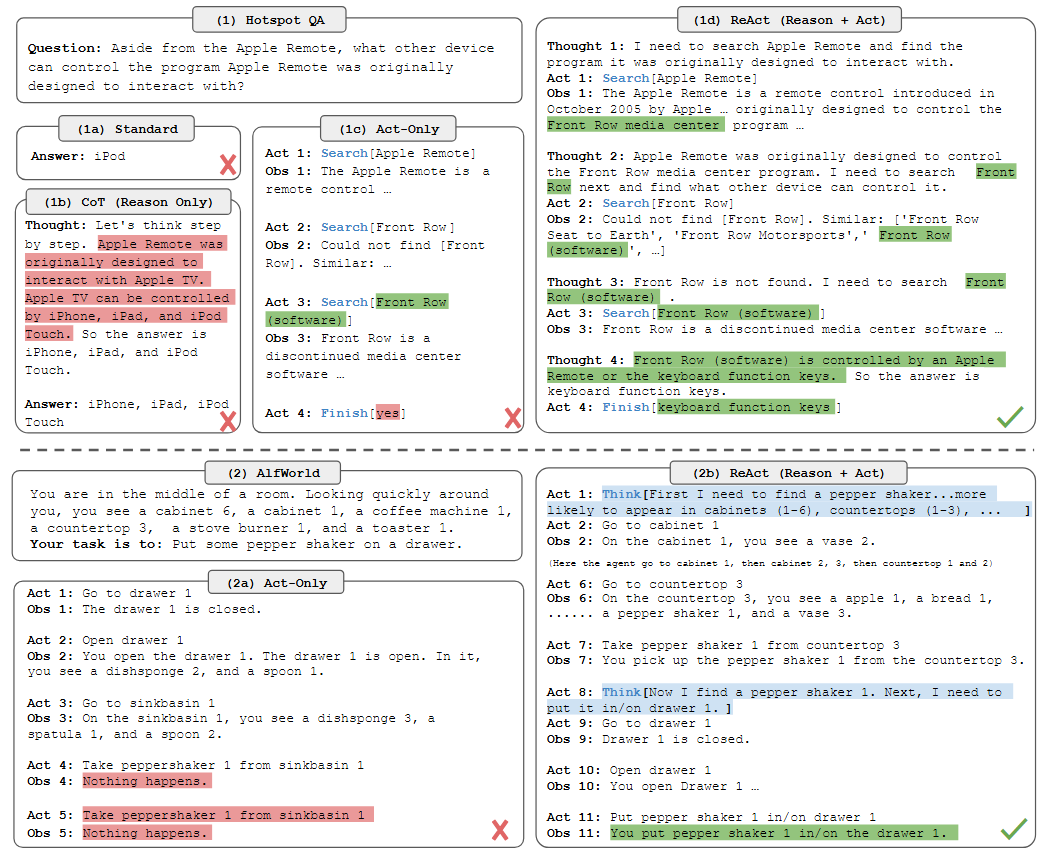
在一个时间步t中,Agent接受当前的观测值,在上下文下,遵循规则并选择当前最适合的操作。关键问题在于找寻规则,使上下文映射至操作。ReAct创新点在于定义操作空间,其中L为语义空间,在Agent思考中则会生成内部动作,该动作仅用于补充上下文而不实际执行,帮助Agent思考问题与拆分问题。
本文基于PaLM-540B模型开展了在Hot-PotQA和FEVER两个数据集上的实验,分别对Standard、CoT、CoT-SC(self-consistency,自一致性,多次思考后投票决定)、Act-Only、ReAct以及CoT-SC→ReAct、ReAct→CoT-SC组合方法展开测试,得出以下结论:
ReAct全方面超过Act-Only。
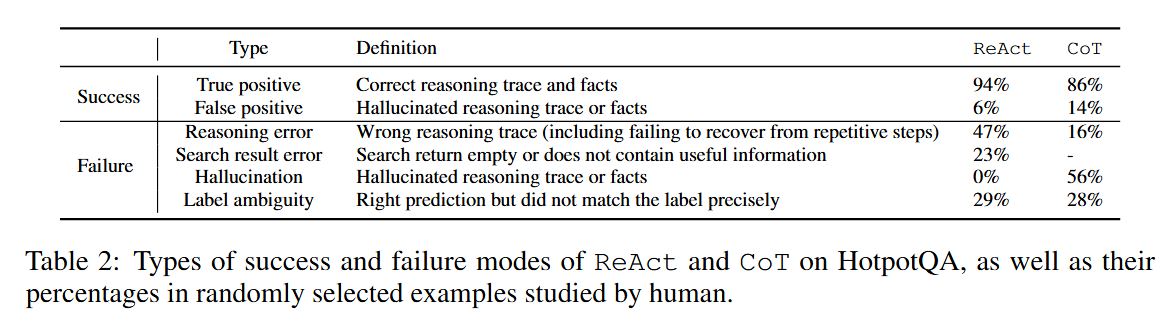
ReAct由于可以自主选择检索外部知识,在实际测试中由于模型幻觉的错误推理的样本数为0,相较于CoT提升显著(CoT无法搜索外部知识库,只能自己思考),且正确检索对Agent的提升显著。
虽然ReAct思考会提高Agent的推理能力,但是由于过于缜密的思考
雷霆思考导致模型可能会反复生成之前的思考内容和动作,从而导致思考错误而进一步导致任务失败,在这项逊色于CoT。ReAct+CoT-SC的组合表现最好。两者结合使用融合支持内部知识与外部信息互补的判断。可以发现随着CoT-SC采样率越高,准确率逐步提高。
ReAct在模型微调下表现最好。微调后的 ReAct(如 PaLM-8B)不仅远高于同规模模型的 Prompt 表现,甚至在 HotpotQA 上超越了 540B 模型使用标准 Prompt 的表现。这证明了 ReAct 范式具有很强的可学习性,且能极大节约推理成本。
2、ToolLLM ICLR 2024
当大模型的Tool过多的时候大模型该如何选择工具?
很明显之前的方法会使用Prompt方法将工具信息丢进去,而当工具数量变多,例如本文中大于1000个的时候,会显著增加计算开销,故需要用一种新方法来选择Tool。本文使用基于深度优先搜索的决策树(depth-first search-based decision tree,DFSDT) ,相较于ReAct,该方法可以有效评估推理路径,可以根据实际情况选择撤回路径。
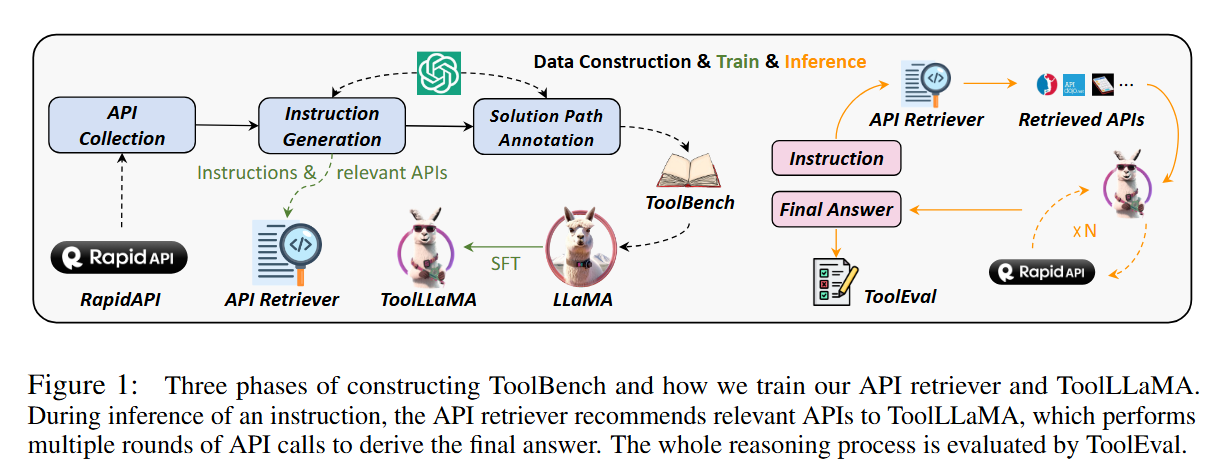
ToolLLM整体框架如下图所示,具体工作流如下
数据集构建:从RapidAPI收集API,使用GPT结合DFSDT对API生成使用说明(同时使用指令和相关API对同步训练API Retriever)和调用API的路径,并构建成数据集ToolBench。
模型训练:结合数据集ToolBench,使用监督微调(Supervised Fine-Tuning,SFT)对LLaMa模型微调出ToolLLaMa
模型推理:用户输入指令,API Retriever检索找回APIs,此时ToolLLaMA进行多轮调用并与真实环境多轮交互,最终输出答案并给ToolEval评估。